데이터 전처리
데이터 정제
데이터 전처리 과정
데이터 정제 -> 결측값 처리 -> 이상값 처리 -> 분석변수 처리
데이터 정제 절차
| 순서 | 데이터 정제 절차 | 설명 |
|---|---|---|
| 1 | 오류 원인 분석 | 원천 데이터의 오류, 빅데이터 플로우의 오류등 |
| 2 | 정제 대상 선정 | 모든 데이터를 대상으로 정제 진행 (품질 저하의 위험이 있는 데이터는 추가 정제) |
| 3 | 정제 방법 결정 | 오류 데이터를 삭제, 대체, 예측값으로 삽입 |
데이터 오류 원인분석
| 원인 | 설명 | 처리 방법 |
|---|---|---|
| 결측값(Missing Value) | 필수적인 데이터가 입력되지 않고 누락된 값 | 경향값 넣기 (평균값, 중앙값, 최빈값), 확률 분포 기반 랜덤값 넣기 |
| 이상값(Outlier) | 데이터의 범위에서 벗어난 값 | 하한값, 상한값 대체 |
| 노이즈(Noise) | 데이터가 존재하지 않지만 입력되었다고 잘못 판단된 값 | 일정 규칙을 가지고 평균값 대체 |
데이터 정제 기술
- ETL ( Extract, Trasform, Load ) : 수집이 필요한 데이터를 추출, 가공(변환, 정제)하여 데이터 웨어하우스 및 데이터 마트에 저장하는 기술
- 맵 리듀스 ( Map Reduce ) : Key-Value 형태로 구성되며 데이터의 양이 많아지면 성능저하
- 스파크/스톰 : 인 메모리 기반 데이터 처리 방식, 맵 리듀스 성능문제 개선
- CEP : 실시간 이벤트에 대한 데이터를 처리하는 기술, IOT센싱 데이터, 음성 데이터
- 피그 : 대용량 데이터 집합 분석 플랫폼, 하듑을 이용해서 맵리듀스를 하기 위한 자체언어 ‘피그 라틴’ 제공
- 플룸 : 로그 데이터를 수집하고 처리리
데이터 세분화
- 데이터 세분화는 데이터를 기준에 따라 나누고, 선택한 매개변수를 기반으로 유사한 데이터를 그룹화하여 효율적으로 사용할 수 있는 프로세스를 말함.
데이터 세분화 방법
| 구분 | 기법 | 설명 |
|---|---|---|
| 계측적 방법 | 응집분석법 | 각 개체를 하나의 소집단으로 간주하고 단계적으로 유사한 소집단들을 합쳐 새로운 소집단을 구성해가는 기법 |
| 계측적 방법 | 분할분석법 | 전체 집단으로부터 시작하여 유사성이 떨어지는 객체들을 분리해가는 기법 |
| 비 계측적 방법 | 인공신경망 모델 | 기계 학습에서 생물학의 신경망으로부터 영감을 얻은 통계학적 합습모델 |
| 비 계측적 방법 | K-평균 군집화 | K개의 중심좌표를 이용하여 각 개체와 중심좌표 간의 거리를 산출하여, 근접한 개체들을 소집단에 배정해가며 군집화하는 방식 |
데이터 결측값 처리
결측값이란 입력이 누락된 값을 의미하며, 철즉값은 NA, 999999, NULL 로 표현한다.
데이터 결측값 종류
| 종류 | 설명 | 예시 |
|---|---|---|
| 완전 무작위 결측 | 다른 변수들과 아무런 상관없는 경우 | 입력 실수, 전산 오류 |
| 무작위 결측 | 누락된 자료가 특정 변수와 관련되어 일어나지만 그 변수의 결과는 관계 없는 경우 | 특정 정치 성향 유권자들의 응답률은 낮지만 정당의 득표율이 낮은 것은 아님 |
| 비 무작위 결측 | 누락된 값이 다른 변수와 연관이 있는 경우 | 소득이 낮은 응답자들의 응답률이 낮음 |
결측값 처리 방법법
- 완전분석법 : 결측값 가지는 데이터 삭제
- 평균 대치법 : 단순 평균으로 대치
- 회귀 대치법 : 회귀분석의 결과로 대치
- 단순 확률 대치법 : 확률적으로 선택하여 대치
- Nearest Neighbor : 바로 가까운 응답으로 대체
- Hot-Deck : 현재 데이터 셋에서 비슷한 성향으로 대체
- Cold-Deck : 유사한 외부 출처에서 비슷한 성향으로 대체
- 다중 대치법 : 여러 번 대치 (대치 -> 분석 -> 결합)
데이터 이상값 처리
이상값이란 특정 범위에서 벗어난 데이터 값을 의미한다. 이상값을 항상 제거하는 것은 아니다
데이터 이상값 검출 방법
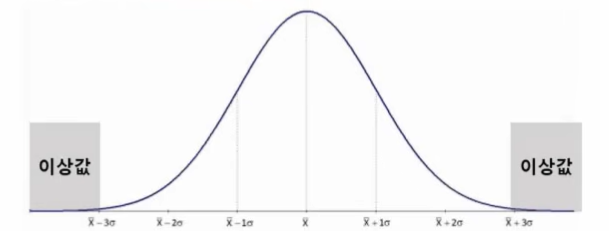
- ESD(Extreme Studentized Deviation)
- 평균으로부터 3배 넘어가는 데이터는 이상값으로 판단
- ESD(Extreme Studentized Deviation)
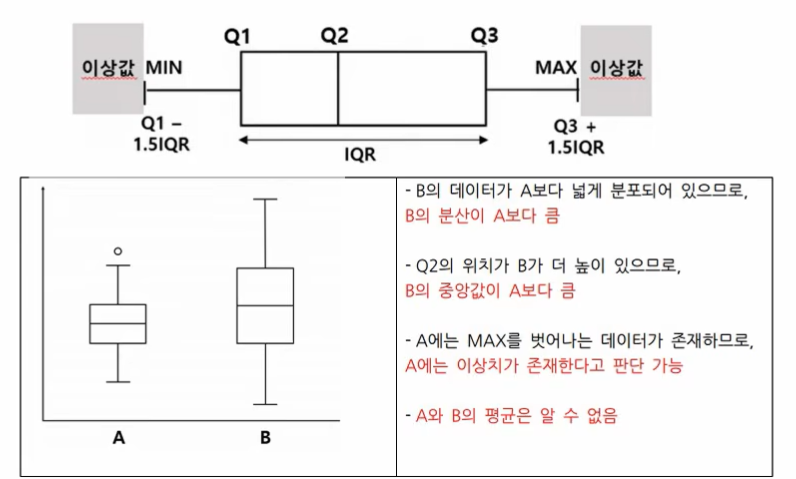
- 사분위수
- Q1 - 1.5IQR보다 작거나, Q3 + 1.5IOR보다 크면 이상값으로 판단단
- 사분위수
- Z-Score
- 데이터를 정규화(평균 0, 표준편차 1) 후, 일정 임계 값을 초과할 경우 이상값으로 판단
- Z-Score
- DBScan
- 밀도를 이용하여 밀도가 적은 부분의 데이터를 이상값으로 판단
- DBScan
분석 변수 처리 (변수 선택)
변수의 유형 및 개념
- 독립변수 : 다른 변수에 영향을 받지 않는 변수
- 종속변수 : 독립변수에 영향을 받아 변화화는 변수
- 수치형 변수 : 연속형(키, 몸무게), 이산형(주사위 결과, 교통사고 건수)
- 범주형 변수 : 순위형 자료(평점, 선호도), 명목형 자료(혈액형, 성별)
변수 선택 방법
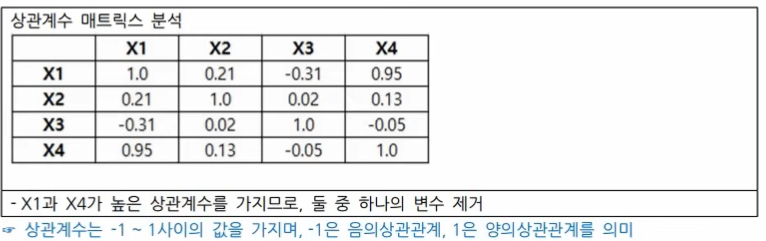
- 전진선택법 : 변수를 하나씩 추가해 나가는 방법
- 후진제거법 : 변수를 하나씩 제거해 나가는 방법
- 단계별 선택법 : 전진선택법과 후진제거법을 함께 사용하는 방법
분석 변수 처리 (차원축소)
차원이란 데이터를 그래프로 표현하기 위한 축의 개수로 변수의 수로 생각하면 된다.
차원의 저주
데이터 학습 시 차원이 높아질수록 알고리즘의 성능이 저하되는 현상
1차원일 경우 5개가 들어갔다고하면 2차원으로 늘어날 경우 공간이 2배로 늘어나며 5개 이외의 공간은 빈공간으로 채워야한다.
차원 축소의 효과
- 차원의 저주 해소, 데이터 시각화, 노이즈 제거, 데이터 압축
차원 축소 기법 (시간이 날 경우 자세히 알아보기)
- 선형 차원 축소 기법
- 주성분 분석 (PCA) : 분산이 최대화되는 방향으로 차원을 축소
- LDA : 분류에서 클래스 간 분산을 최대한하면서 차원을 축소하는 기법
- ICA : 서로 독립적인 성분을 찾아 차원 축소
- SVD : m * n 크기의 비정방행렬 A를 행렬 분해
- 요인분석 : 관측된 변수들을 몇 개의 잠재 요인으로 축소하는 방법
- 비선형 차원 축소 기법
- MDS : 데이터 간 거리정보의 근접성을 보존하는 차원 축소
- t-SNE : 고차원 데이터간 거리 정보를 확률적으로 유지하여 차원 축소
- UMAP : tSNE와 유사한 비선형 차원 축소 기법
- AutoEncode : 신경망을 활용한 차원 축소 기법
분석 변수 처리 (파생변수 생성)
파생변수는 기존 변수에 특정 조건이나 함수 등을 사용하여 새롭게 재정의한 변수
파생변수 생성방법
- 파생변수의 생성 방법에는 단위 변환, 표현방식 변환, 요약 통계량 변환, 변수 결함 등의 방법이 있다.
분석 변수 처리 (변수 변환)
변수 변환
변수 변환은 분석을 위해 불필요한 변수를 제거, 반환, 생성시키는 작업을 의미한다.
수치형 변수 변환
- Z-Score 정규화 : 평균 0, 표준편차 1로 변환 N(0,1)
- 값 - 평균 / 표준편차 로 계산하여 모든 데이터를 일관성있게 처리
- 최소-최대 정규화 : 0~1 사이 값으로 변환
- 값 - 최소값 / 최대값 - 최소값
- 로그 변환 : 로그로 취한 값으로 변환, 데이터가 한쪽으로 치우쳐 있을 시 사용
- 그 외 변환 기법들 : 지수변환, 제곱근 변환, Box-Cox 변환
범주형 변수 변환
- 레이블 인코딩 : 데이터를 정수로 변환
- 오렌지, 바나나, 포도 -> 0, 1, 2 (포도가 바나나 보다 크다고 인식하는 문제 존재)
- 원-핫 인코딩
- 고유 값에 해당하는 컬럼만 1로 표시
- 오렌지, 바나나, 포도 -> [1,0,0],[0,1,0],[0,0,1]
- 고유 값에 해당하는 컬럼만 1로 표시
- 타깃 인코딩
- 타깃 변수를 평균값으로 변환
날짜/시간 변수 변환
- 분할 : 날짜/시간 데이터를 년, 월, 일, 시, 분 으로 분할
- 파생 : 시간대(오전, 오후), 요일 또는 계절 등의 파생변수 생성
분석 변수 처리 (불균형 데이터 처리)
데이터의 수가 크게 차이가나 불균형이 발생했을때 처리나느 방법
- 가충치 균형 적용 : 불균형 데이터에 가충치를 주는 방법
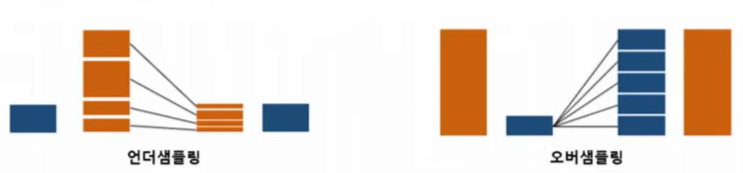
- 언더샘플링 : 다수 데이터의 일부만 선택
- 방법 : 랜덤, 계통, 집락, 총화
- 오버샘플링 : 소수 데이터를 복사하거나 유사한 데이터를 만드는 방식
- 방법 : SMOTE, ADSYN, ROS