INDEX
기존에는 테이블의 모든 데이터를 순회(Table Full Scan)하며 검색을 하기 때문에 오래 걸렸다. INDEX는 이를 해결하고자 책 뒷편에 존재하는 ‘색인’과 동일한 역할을 하도록 만들어진 자료구조이다.
Index를 생성하게 되면 해당 컬럼의 데이터들을 정렬하여 별도의 메모리 공간에 데이터의 물리적 주소와 함께 저장된다. 이렇게 인덱스가 생성하였다면 앞으로 쿼리문 작업할 때 옵티마이저에서 판단하여 생성된 인덱스를 탈 수 있다.
즉, 저장 성능을 희생하고 검색 성능을 높이기 위해 만들어진 자료구조이다.
Index 생성 원리
- 해당 테이블을 모두 읽고 인덱스를 만드는 동안 데이터가 변경되면 문제가 되므로 해당 데이터들이 변경되지 못하도록 조치한 후 메모리(PGA의 Sort Area)에서 정렬
- 전체 테이블 스캔 → 정력 → Block 기록 (PGA내의 Sort Area 공간 부족시 Temporary Tablespace이용해 정렬)
Index 동작 원리
SELECT 문 발생이후 Server Process가 구문분석 과정을 마친후
- Database Buffer Cache에 조건에 부합하는 데이터가 있는 확인
- 존재 O : cache에서 리턴
- 존재 X, Index X : 모든 데이터를 Database Buffer Cache에 복사 이후 Full Table Scan하여 결과 리턴
- 존재 X, Index O : Where 절 확인이후 부합하는 인덱스 ROWID에 있는 블럭을 찾아가 해당 블럭만 Database Buffer Cache에 복사 이후 리턴
Index 관리
DBMS는 Index를 항상 최신의 정렬된 상태로 유지를 해야한다. 그렇기 때문에 INSERT, UPDATE, DELETE가 발생할 때 각각 추가적인 작업을 해야해서 오버헤드가 발생한다.
- INSERT: 새로운 데이터에 대한 인덱스를 추가함
- DELETE: 삭제하는 데이터의 인덱스를 사용하지 않는다는 작업을 진행함
- UPDATE: 기존의 인덱스를 사용하지 않음 처리하고, 갱신된 데이터에 대해 인덱스를 추가함
그렇기 때문에, 자주 변동이 일어나는 속성에 인덱스를 걸게 되면 인덱스의 크기가 비대(DELETE, UPDATE 시 사용하지 않음 처리로 크기가 커짐)해지고 오버헤드가 계속 발생하기 때문에 오히려 성능이 떨어질 수 있다. 그리고 또한 Index 저장 공간은 데이터베이스 전체 공간의 약 10%라고 한다. 즉, 잘못 사용하면 불필요한 저장 공간을 낭비하게 된다.
그렇기 때문에 아래와 같은 상황일 때 사용하면 좋다.
- 규모가 작지 않은 테이블
- INSERT, UPDATE, DELETE가 자주 발생하지 않는 컬럼
- JOIN이나 WHERE 또는 ORDER BY에 자주 사용되는 컬럼
- 데이터의 중복도가 낮은 컬럼
Index 자료구조
Index를 구현하기 위해서는 다양한 자료구조가 존재한다.
Hash 인덱스
해시 테이블은 (Key, Value)로 데이터를 저장하는 자료구조 중 하나로 빠른 데이터 검색이 필요할 때 유용하고, Key값을 이용해 고유한 index를 생성하여 그 index에 저장된 값을 꺼내오는 구조이다.
DB 인덱스에서 해시 테이블이 사용되는 경우는 제한적인데, 해시 함수는 값이 다르면 완전히 다른 해시 값을 생성하기 때문에 등호(=) 연산에만 특화되었기 때문이다. 이러한 특성에 의해 부등호 연산(>, <)이 자주 사용되는 데이터베이스 검색을 위해서는 해시 테이블이 적합하지 않다.
B-Tree 인덱스
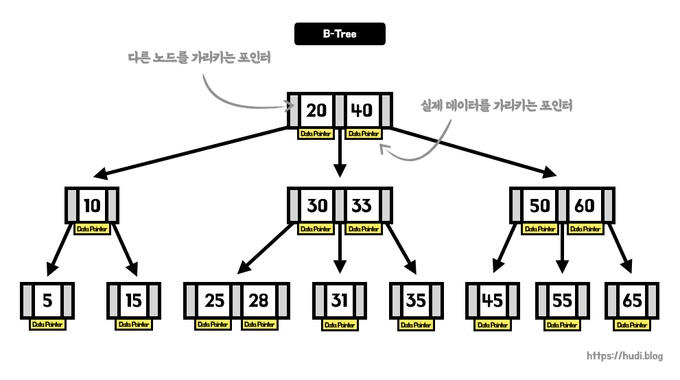
B-Tree는 자식 2개 만을 갖는 이진 트리(Binary Tree)를 확장하여 N개의 자식을 가질 수 있도록 고안된 것이다. 그리고 좌우 자식 간의 균형이 맞지 않을 경우에는 매우 비효율적이라, 항상 균형을 맞춘다는 의미에서 균형 트리(Balanced Tree)라고 불린다. B-Tree는 최상위에 단 하나의 노드 만이 존재하는데, 이를 루트 노드 (Root Node)라고 한다. 그리고 중간 노드를 브랜치 노드(Branch Node), 최하위 노드를 리프 노드(Leaf Node)라고 한다.
B+Tree 인덱스
B-Tree는 어떤 한 데이터의 검색에서는 빠를 수 있으나, 모든 데이터를 순회하기 위해서는 leaf node까지 갔다가 다시 부모 node로 BackTracking하여 트리의 모든 node를 방문해야 하므로 비효율적이다. 이러한 단점을 보완한 것이 B+Tree이다. 그래서 B+Tree 는 최하단 Leaf Node에만 데이터를 가지고 있다.
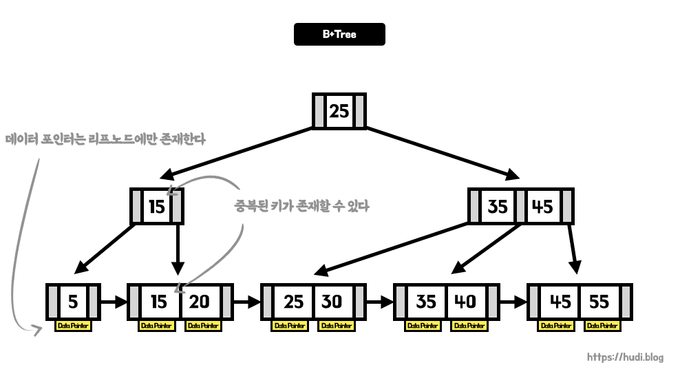
데이터베이스의 인덱스 컬럼은 부등호를 이용한 순차 검색 연산이 자주 발생될 수 있다. 이러한 이유로 BTree의 리프노드들을 LinkedList로 연결하여 순차검색을 용이하게 하는 등 BTree를 인덱스에 맞게 최적화하였다.
| - | B-Tree | B+Tree |
|---|---|---|
| 데이터 저장 | 모든 node에 저장 | leaf node에만 저장 |
| key의 중복 | 중복 없음 | 중복 존재 가능 |
| Full Scan | 모든 node를 순회하며 탐색 | linked list를 통해 leaf node만 선형 탐색 |
| key를 통한 탐색 | leaf node까지 가지 않아도 되는 경우가 있음 | 무조건 leaf node까지 가야 함 |
| 높이 | 비교적 높음 | 비교적 낮음 |
Index 종류
클러스터형 인덱스 (Clustered Index)
클러스터형 인덱스는 테이블 전체가 정렬된 인덱스가 되는 방식의 인덱스 종류이다. 실제 데이터와 무리(Clustered)를 지어 인덱싱 되므로 클러스터형 인덱스라고 부른다.
클러스터형 인덱스 특징은 아래와 같다.
- 클러스트형 인덱스는 전체 테이블이 물리적으로 정렬된다.
- 클러스터형 인덱스는 테이블당 하나만 존재한다.
- PK 컬럼 또는 Unique + NotNull 컬럼을 지정하면 클러스터형 인덱스를 생성한다.
- 두 가지경우가 없을 경우
GEN_CLUST_INDEX라는 컬럼을 생성하여 클러스터형 인덱스를 생성한다.
Q. PK 컬럼은 비클러스터형 인덱스가 될 수 없을까?
A. 가능하다. 하지만 하나밖에 생성못하는 클러스터형 인덱스 특징상 보통 Primary Key를 기준으로 조회를 많이 하기 때문에 database에서 기본으로 잡아준다.
만약 PK를 고유값 기능으로만 사용한다면 다른 컬럼을 클러스터형 인덱스로 잡는게 좋다.
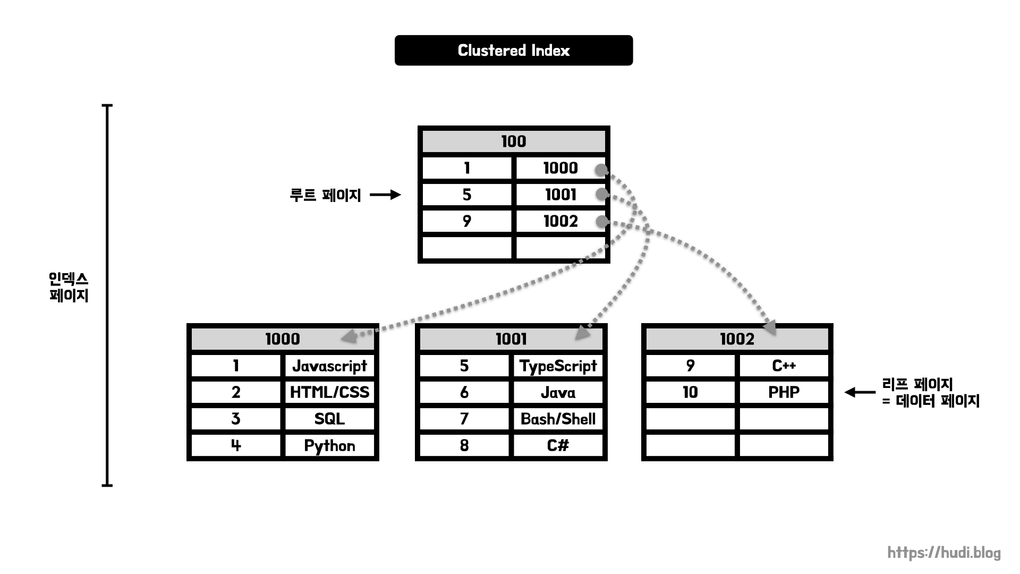
클러스터형 인덱스는 위 그림처럼 B+Tree의 형태로 구성되어 있다. 앞으로 여기서 B+Tree의 노드를 데이터베이스에서는 페이지라고 부른다. 각 페이지는 고유의 페이지 번호를 가지고 있다. 위 그림은 rank 컬럼을 PK로 설정해 클러스터형 인덱스를 생성한 모습이다.
루트 페이지를 보면 Key로는 PK를 가지고 있고, 포인터로는 다른 페이지의 페이지 번호를 가지고 있다. 또, 리프 페이지는 Key로 PK를 가지고 있고, 데이터를 직접 가지고 있는 것을 확인할 수 있다.
비클러스터형 인덱스 (Non-Clustered Index)
비클러스터형 인덱스는 보조 인덱스(Secondary Index)라고도 불리며, 클러스터형 인덱스와 다르게 물리적으로 테이블을 정렬하지 않는다. 그 대신 정렬된 별도의 인덱스 페이지를 생성하고 관리한다. 즉, 비클러스터형 인덱스는 데이터를 가지고 있지 않다. 또한 비클러스터형 인덱스는 테이블당 여러개 생성가능하다.
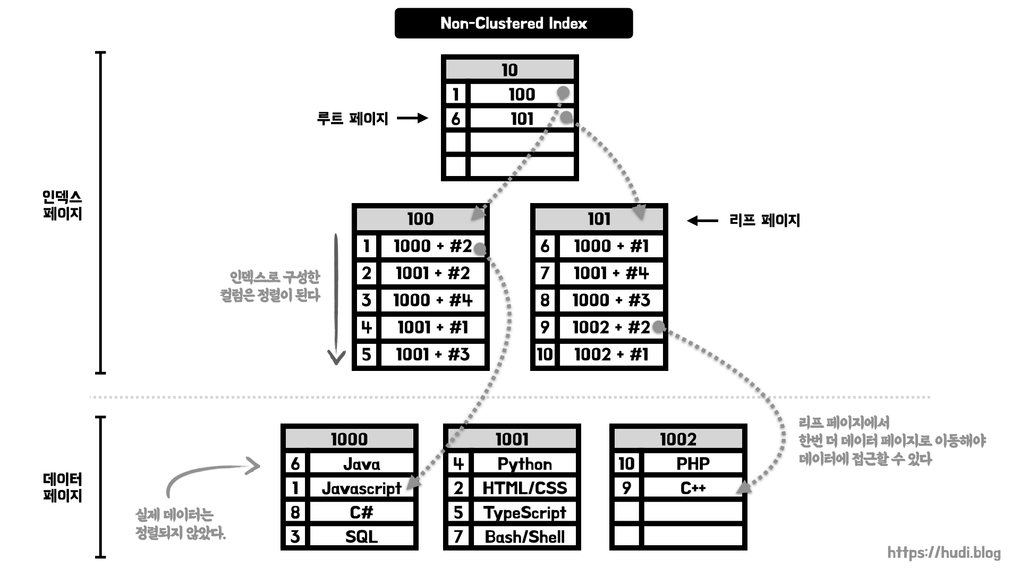
비클러스터형 인덱스의 경우 인덱스 페이지와 데이터 페이지로 구분되어 있다.
구분되어 있는 이유는 리프 페이지가 조금 다르다. 인덱스 컬럼을 가지고 있는 것은 비슷하지만, 데이터를 직접 가지고 있지 않으며 데이터 페이지 번호 + #오프셋 을 가지고 있어 데이터 페이지의 특정 행을 가리킨다. 즉, 데이터에 접근하기 위해서는 인덱스 페이지에서 데이터 페이지로 이동하는 하나의 과정이 추가된다.
인덱스 페이지는 정렬되어 있지만, 실제 데이터 페이지는 정렬되지 않으므로 클러스터형 인덱스에 비해 삽입, 수정, 삭제 작업이 비교적 빠르다. 데이터 페이지에는 정렬 순서 상관없이 빈 곳에 데이터를 삽입하면 되기 때문이다.
클러스터형 인덱스와 비클러스터형 인덱스의 혼합
보통 인덱스는 PK는 기본적으로 존재하고, 추가로 조회가 자주 발생하는 컬럼에 대해 인덱스를 추가하기 때문에 하나에 테이블에 클러스터형 인덱스와 비클러스터형 인덱스가 혼합되어 있는 경우가 많다.
이런 경우에는 비클러스터형 인덱스를 먼저 거치고, 이어 클러스터형 인덱스를 거쳐 데이터를 찾는다. 이때, 비클러스터형 인덱스는 데이터 페이지 번호 + #오프셋 대신 클러스터형 인덱스에 대한 컬럼 값을 갖는다.
Q. 왜 혼합 구조에서는 비클러스터형 인덱스에서 PK값을 가지고 있는 것일까?
A. 테이블에 데이터가 추가, 수정, 삭제 되면 테이블 데이터의 페이지 번호와 페이지 내 순서가 모두 변경된다.
비클러스터형 인덱스가
데이터 페이지 번호 + #오프셋정보를 직접 들고 있으면, 페이지 번호가 변경 될 경우 비클러스터형 인덱스를 모두 수정해야하는 치명적인 문제점이 발생한다. 하지만 PK를 가지고 있을 경우 정렬된 클러스터 인덱스로 접근하여 찾기만 하면 된다.
참고 자료 :
- https://hudi.blog/db-clustered-and-non-clustered-index/